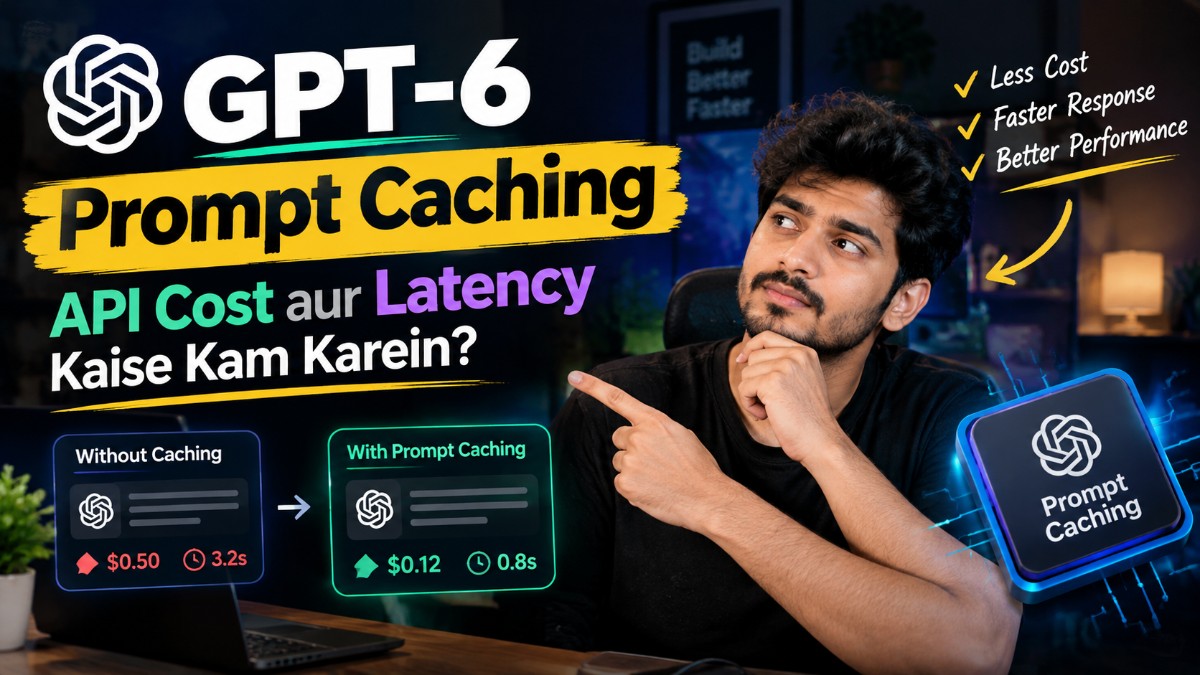
GPT-6 Prompt Caching: API Cost aur Latency Kaise Kam Karein?
GPT-6 prompt caching repeated API requests mein same instructions, tools aur context ki computation reuse karta hai. AI agents aur support bots mein stable content ko prompt ke start mein rakhkar cost aur latency optimize ki ja sakti hai.
GPT-6 prompt caching kya hai?
Prompt caching API ko identical prompt prefix ki pehle ki computation reuse karne deta hai. “Prefix” ka matlab prompt ka starting portion hai: system instructions, tool schemas, policies ya reference material. User ka changing question aur session-specific data end mein rakhna practical pattern hai.
OpenAI ke 22 September 2026 announcement ke mutabik, GPT-6 family eligible shared prefixes ko 30-minute window mein reuse kar sakti hai aur cached input-token reads par up to 90% discount mil sakta hai. “Up to” workload-dependent hai; actual savings cache-hit rate aur reusable-token share par depend karegi.
Kaunse prompts cache ke liye eligible hain?
Official guide ke अनुसार GPT-5.6 aur newer models mein minimum cacheable prompt 1,024 tokens ka hai. Reuse ke liye model, tools, settings aur prefix compatible rehne chahiye.
- Stable system instructions aur policies sabse pehle rakhein.
- Tool definitions ka schema aur ordering unnecessarily change na karein.
- Frequently changing user input, timestamps aur retrieved data end mein rakhein.
- Usage response aur Prompt Caching Dashboard mein cached versus uncached tokens monitor karein.
Implicit aur explicit caching mein difference
| Mode | Kab use karein | Control |
|---|---|---|
| Implicit caching | Simple repeated prefixes aur quick setup | Platform automatically eligible prefix identify karta hai |
| Explicit breakpoints | Long agents, large tool lists aur predictable shared context | Developer reusable prefix ki boundary choose karta hai |
Explicit breakpoints stable prefix aur changing context ko separate karte hain. Ek request mein maximum four cache writes supported hain, isliye breakpoints selectively use karein.
Step-by-step optimization workflow
1. Prompt ko stable aur dynamic blocks mein split karein
Stable block mein role, output format, safety rules, tool schemas aur fixed knowledge rakhein. Dynamic block mein user message, live search results ya current task data rakhein. Yeh approach AI aur automation workflows ke liye especially useful hai.
2. Longest reusable prefix banayein
Stable elements ko same order mein serialize karein. Whitespace, tool schema ya instruction wording mein unnecessary changes cache miss cause kar sakte hain. Naye instructions ko prefix rewrite karne ki jagah prompt ke end mein append karna better ho sakta hai.
3. Known context ko prewarm karein
Latency-sensitive app startup par prompt_cache_options.prewarm: true ke saath shared context prepare kar sakti hai. Prewarming user ke first request se pehle computation shift karta hai; ise sirf predictable, genuinely reused context ke liye use karein.
4. Hit rate measure karke iterate karein
Dashboard mein cached-input ratio track karein. Sudden drop aaye to model, tools, settings aur prefix diff inspect karein. n8n automation jaise multi-step flows mein har node ko same stable prefix convention follow karwana helpful hai.
Cost ko realistic tarike se kaise evaluate karein?
Cache write uncached input se mehenga, जबकि cache read substantially cheaper ho sakta hai. 20–50 representative requests par cached tokens, write/read frequency aur time-to-first-token compare karein. Output tokens aur changing suffix ki cost alag count karein.
Common mistakes
- Har request mein timestamp ya random ID prompt ke start mein rakhna.
- Tool definitions ko remove, reorder ya rename karte rehna.
- Sirf advertised maximum discount dekhkar total bill saving assume karna.
- Cache-hit metrics measure kiye bina rollout karna.
FAQs
Kya prompt caching automatically enabled hai?
Eligible requests ke liye implicit caching platform level par work kar sakti hai. Explicit breakpoints tab useful hain jab aap reusable prefix par tighter control chahte hain.
Kya cached prompt se answer quality change hoti hai?
Caching same prefix ki computation reuse karta hai; iska purpose output quality setting ko reduce karna nahi hai. Phir bhi production changes ko evals se validate karein.
Kya har GPT-6 request 90% cheaper ho jayegi?
Nahi. Up to 90% discount cached input-token reads par hai, complete request par nahi. Actual saving reusable-prefix size, hit rate, writes, dynamic input aur output tokens par depend karegi.
Cache miss diagnose kaise karein?
Prompt Caching Dashboard aur diagnostics tool se model, tools, settings ya input change identify karein. Stable prefix ka diff version control mein store karna debugging ko easier banata hai.
Final takeaway
Best pattern hai: stable context first, dynamic context last, limited breakpoints aur continuous measurement. Representative workload benchmark karne ke baad hi production rollout karein.